
PDF 工具:切分、合并、压缩、加密、裁剪与书签
从 实用工具 → PDF 工具 进入对应工具。以下用自制的六页“课程资料”PDF 演示:封面、目录、两页讲义和两页练习,页面上印有 1–6 便于核对。操作前保留原 PDF,下载后再检查页数、页序、文字和书签。
这些工具可从网页版和客户端打开,实际处理页面需要加载成功。手机窄屏下,配置和下载入口通常收在紫色菜单中。当前六项 PDF 工具如下:
| 工具 | 输入与用途 | 输出 |
|---|---|---|
| 切分 | 一份 PDF,拆为多个片段或提取页 | 单片 PDF、ZIP |
| 合并 | 多份 PDF,按顺序或交错组合 | |
| 压缩 | 一份或多份 PDF,调整体积与质量 | PDF、ZIP |
| 加密 / 解密 | 一份 PDF,设置打开密码或用原密码解密 | |
| 裁剪 | 一份 PDF,调整页面可见范围 | |
| 书签编辑 | 一份 PDF,编辑目录书签及目标页 | 带书签 PDF、书签文本/JSON |
图片要合成 PDF,可使用扫描工作台:添加图片、排页、确认预览后下载 PDF。它输出图片型 PDF;本页没有独立“图片转 PDF”菜单步骤。需要 Word 或 Markdown,应先解析文档,再在解析工作区导出。
切分:提取指定页或分成若干份
- 打开 切分,上传示例 PDF,等待总页数和预览显示。
- 选择切分模式,并先用小范围验证:
| 模式 | 操作示例 | 注意 |
|---|---|---|
| 按页码范围 | 输入 1-2,3-4,5-6 | 分别生成三个片段;页码以 PDF 的实际页面位置计算 |
| 均分 | 选择份数,或设置每份页数为 2 | 最后一份可能页数较少 |
| 按文件大小 | 设置目标大小 | 按平均页面体积估算,结果不保证严格等于或小于目标 |
| 按书签 | 选择已有书签层级 | 必须先有正确书签;按所选层级形成片段,下载后核对完整范围与新文件中的书签目标 |
- 调整输出命名规则,点击开始切分。
- 逐个预览结果,确认起止页、片段数和顺序。精确拆章节时,先在原 PDF 找出本章起止位置,再手填范围。
- 下载需要的单片 PDF,或 全部下载 ZIP。ZIP 解压后再次检查每份文件。
界面中的误差容忍、输出顺序或保留书签设置,不应作为结果一定满足这些条件的保证。特别是依赖原书签的资料,下载后需在 PDF 阅读器中验证;必要时用书签编辑工具补齐。
按大小与均分:实际文件可能仍超限
按大小 根据平均页面体积估算范围,不能保证每份 PDF 严格小于目标;均分 按页面组织,也不保证体积相等。下载 ZIP 后应解压检查每份 PDF,而不是只看压缩包大小或界面舍入后的 MB。
2026-10-13,我们另外制作了一份八页 PDF:七页短文字,第 3 页为带人工纹理的模拟扫描图。纹理用于形成明显不均的页面体积,这不是客户扫描件,也不是一般压缩率的代表。原稿共 1,941,743 字节,实际执行了以下操作:
| 当前设置 | 输出对应的原页 | 各份实际字节数 |
|---|---|---|
| 按大小:目标 1 MB,误差容忍 10% | 1–4;5–8 | 1,936,730;3,521 |
| 均分:按份数分割,3 份 | 1–3;4–6;7–8 | 1,936,020;2,850;2,100 |
页码范围:3 | 3 | 1,934,664 |
| 对提取出的单页使用标准压缩(75% 质量) | 仍为原第 3 页 | 772,682 |
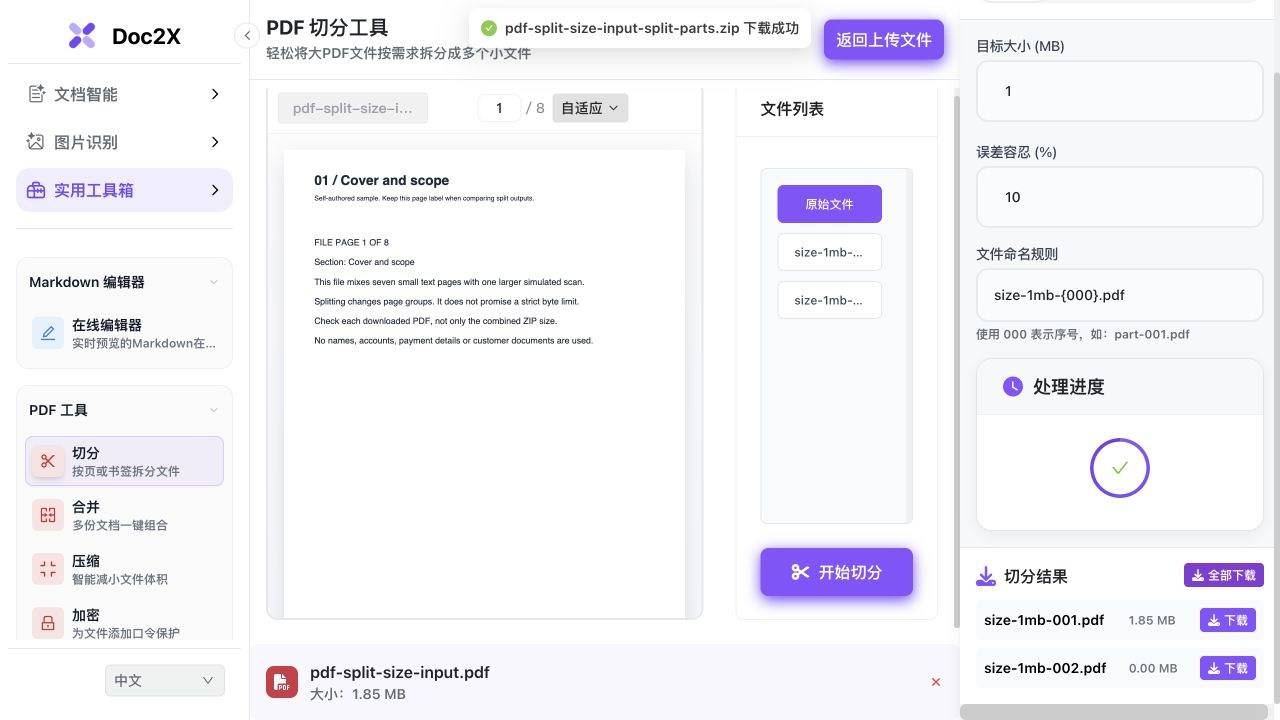
两份完整切分 ZIP 分别覆盖全部原页 1–8,没有漏页或重复页,逐页内容流、文字、尺寸、旋转和嵌入图片与原稿匹配。0.00 MB 并不一定是空文件:本例第二份有 3,521 字节、四页内容及结尾标记,只是 MB 显示进行了舍入。请看实际文件属性并重新打开。
单独第 3 页仍大于 1 MB,因此仅继续按页拆分无法把完整这一页缩到限制内。本次后续操作为:
- 在 页码范围 填
3,重新点击 开始切分,下载单页原件。 - 打开 压缩,选择这个实际下载的单页 PDF;保留原件。
- 选择 标准(75%质量)、全部页面;本次三个结构与标题选项保持开启。
- 点击 开始压缩,再下载本次结果。核对文件大小、页数和图表,不把“完成”当作所有内容都已验收。
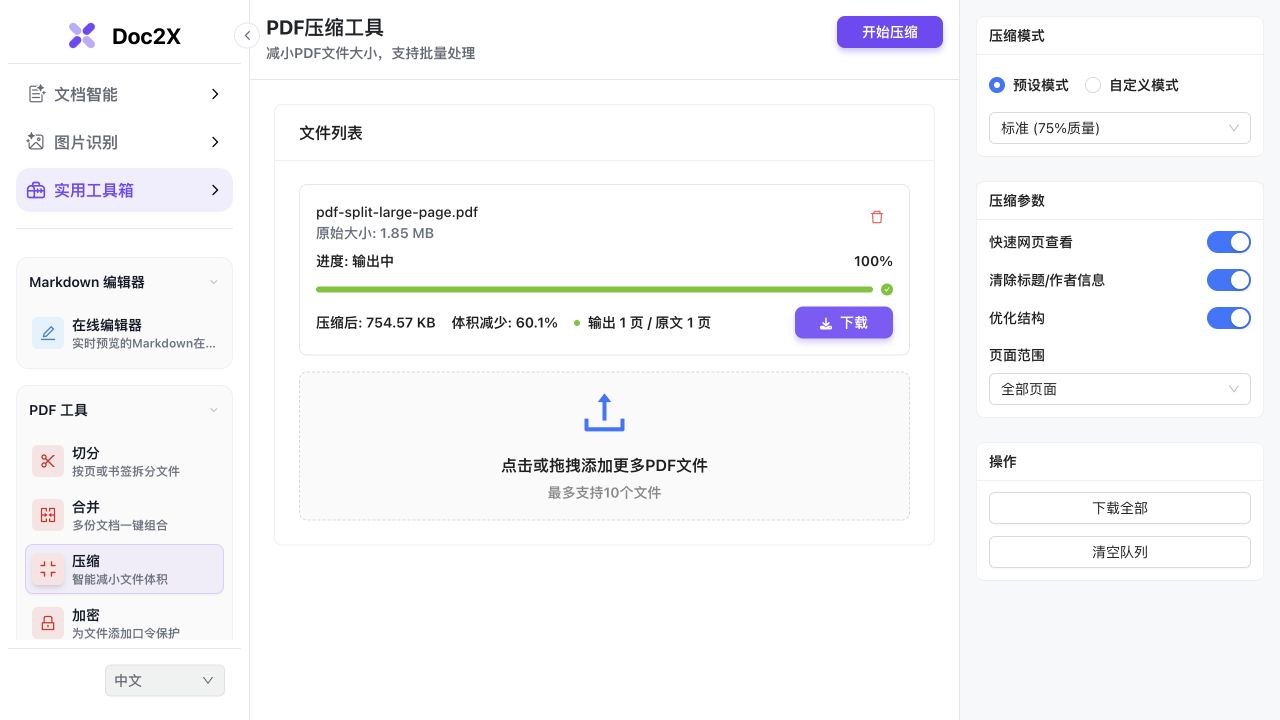
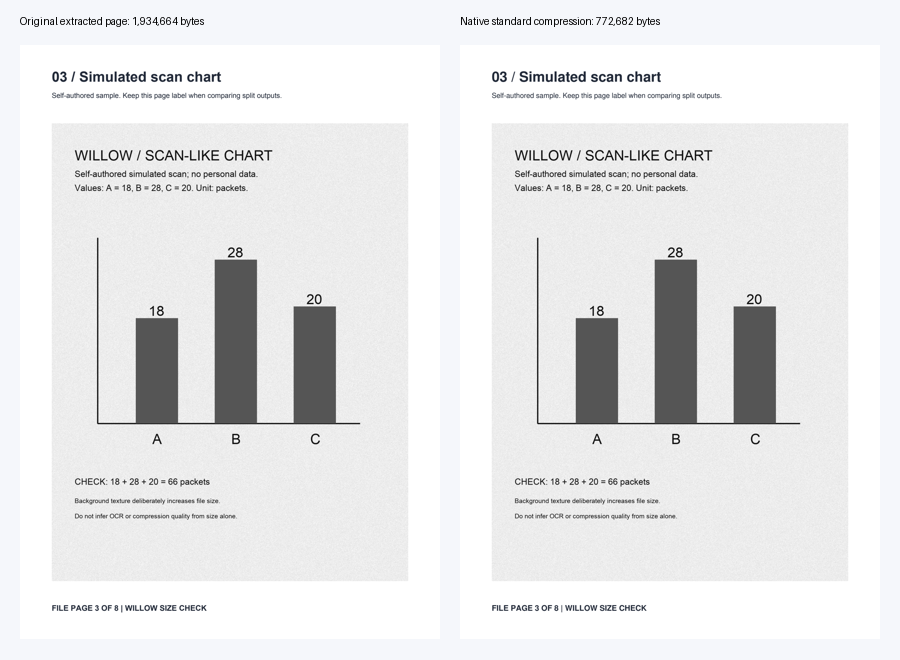
压缩后仍为一页 595 × 842 点;标题和页脚的提取文字仅末尾换行不同。原 1400 × 1800 图像变为 JPEG 编码,像素改变;图中 18、28、20、合计 66、柱形和标注已目视核对,但图中文字仍在图片里,没有新增可选文字层或执行 OCR。自己的小字、公式和细线应另外检查。
下载八页原稿、两份原始切分 ZIP、单页、压缩件与核对说明。外层包在本地整理,里面的工具下载未改写。均分和单页提取沿用了此前的 size-1mb 文件命名,辨认结果应看包名、页内 FILE PAGE 标记与字节对照表,不能只凭文件名判断参数。
这次实测未验证书签、表单、数字签名、密码文件或大批量资料;误差容忍也不能被当作严格上限。若接收平台只允许一个文件,先确认拆分是否符合要求;若需要更小文件又不能牺牲清晰度,应按对方要求调整交付方式。
章节重排:拆分合并后核对书签
2026-10-13,使用当前线上工具复核一份自编八页讲义:前两页为封面和目录,三个章标题在文件第 3、5、7 页,小节在第 4、6、8 页。选择 按书签 → 一级书签(L1),并保留原书签结构,实际下载得到三份完整的两页章节。
- 核对拆分文件。 三份章节分别包含原页 3–4、5–6、7–8;每份书签目标为本文件第 1、2 页。本轮单独下载的
part-001.pdf与“全部下载”ZIP 内对应文件逐字节一致。 - 按用途重排。 在合并工具先添加
part-003.pdf,再添加part-001.pdf,选择顺序合并并开启保留书签。第三章在前、第一章在后,输出四页。 - 重新打开下载件。 在书签工具打开实际合并 PDF,逐条点击四条书签,页码指示器分别到达
1 / 4、2 / 4、3 / 4、4 / 4。检查章标题与正文,不仅看数量。
| 书签 | 八页原稿位置 | 拆分后的单章位置 | 重排合并位置 | 保留的印刷页码 |
|---|---|---|---|---|
| Chapter 3: Review | 7 | 1 | 1 | 5 |
| Review: Answers | 8 | 2 | 2 | 6 |
| Chapter 1: Area | 3 | 1 | 3 | 1 |
| Area: Worked example | 4 | 2 | 4 | 2 |
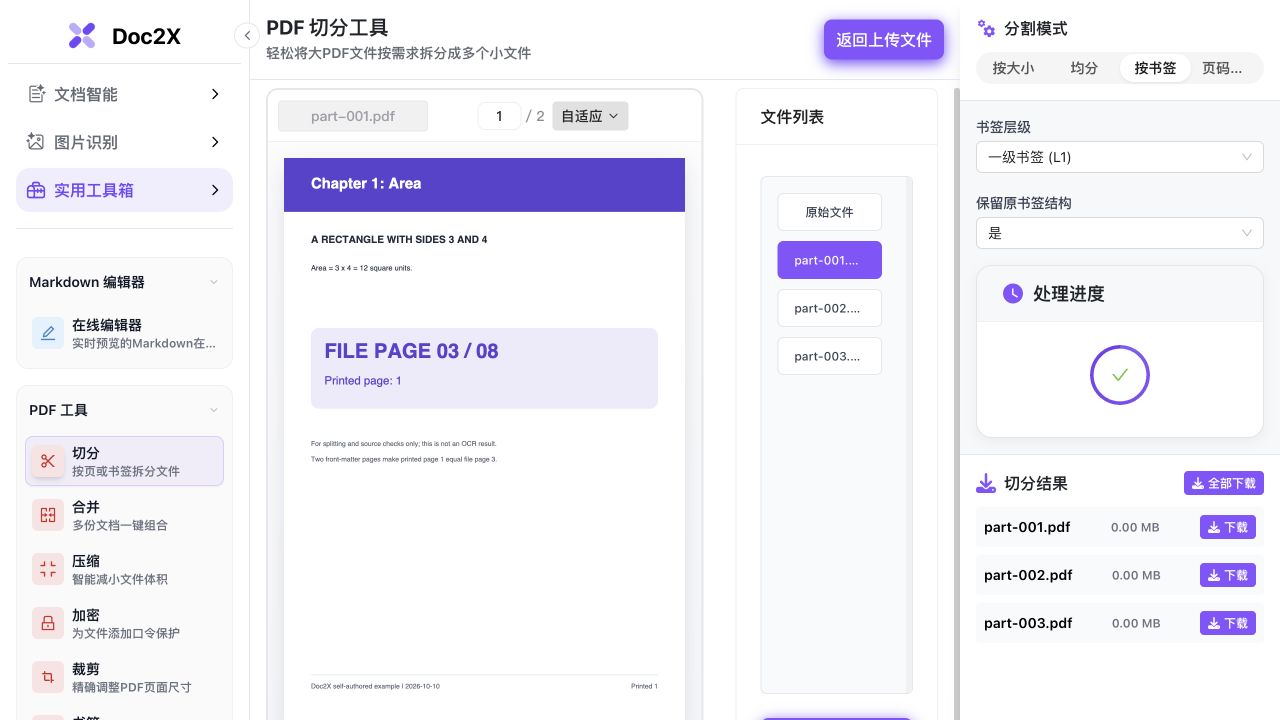
当前工具实际拆分第一章的两页预览,原页面上的 FILE PAGE 03/08 与印刷第 1 页仍保留。
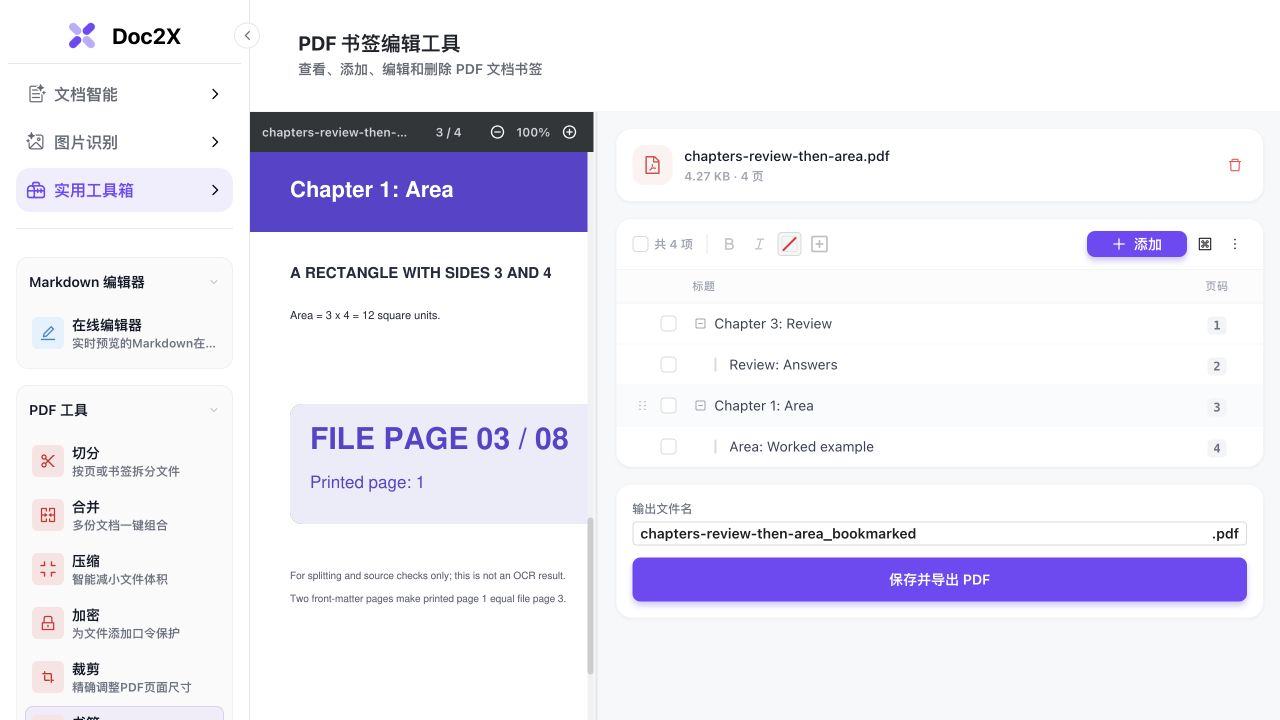
新文件页序与正文印刷数字是不同信息。合并保留了原页面内容流、文字和尺寸,没有把“第三章”改叫“第一章”,也没有重新印刷页脚数字。第三章从原第 7 页到新第 1 页,第一章从原第 3 页到新第 3 页,不能再对全部书签统一加减一个偏移量。
下载八页原稿、实际章节 ZIP、第一章单文件、重排成品与核对记录。核对包为本地整理,包内工具下载文件未改写;没有使用 OCR、翻译或 AI 目录识别。小型文字样例不代表损坏、加密、签名或大型文件的结果。
合并:顺序装订或交错页
- 打开 合并,选择要组合的 PDF。当前上传界面提示最多 20 份;本轮使用两份文件,自己的批量数量与大小应按当前页面条件检查。
- 在文件列表拖动排序。示例先放“讲义”,后放“练习”。选错的文件先移除,再补入正确文件。
- 在 合并方式 中选 顺序合并,得到第一份全部页面后接第二份全部页面。交错合并 可填写“每个文件取页数”,按每份 1 页或多页轮流组合;正反面扫描应先确认各自页序。
- 填写 输出文件名,点击开始合并,等待结果可下载。
- 下载 PDF,检查总页数是否等于各来源页数之和,确认开头、文件交界和末尾没有漏页或反序。
填写取页数后重新开始合并,再下载本次结果。较短文件用完后,继续保留其余文件的剩余页面;不会自动补白或纠正反序。保留书签 的目标按新文件位置核对,不能只看保留开关。
英文合并实测:取页组数与书签目标
英文 PDF 合并指南对应当前英文合并工具,提供 2026-10-13 的原稿与两次实际下载。A 是三页竖版,B 是两页横版。
- 用 Select Files 选择 A 和 B,确认顺序,开启 Keep Bookmarks。
- 选择 Sequential Merge,设置输出名,点击 Start Merge 后 Download。保存顺序为 A1、A2、A3、B1、B2。
- 改为 Interleaved Merge,将 Pages per File 设置为 2,改输出名并重新处理。新下载件顺序为 A1、A2、B1、B2、A3。
- 打开两份结果,核对文件边界和书签目标。改变设置不会更新先前下载的文件。
| 原有书签 | 顺序合并结果 | 每次两页交错结果 |
|---|---|---|
| A - Report | 第 1 页 | 第 1 页 |
| A - Methods,Report 的子项 | 第 2 页 | 第 2 页 |
| A - Findings,Report 的子项 | 第 3 页 | 第 5 页 |
| B - Appendix | 第 4 页 | 第 3 页 |
| B - Table,Appendix 的子项 | 第 5 页 | 第 4 页 |
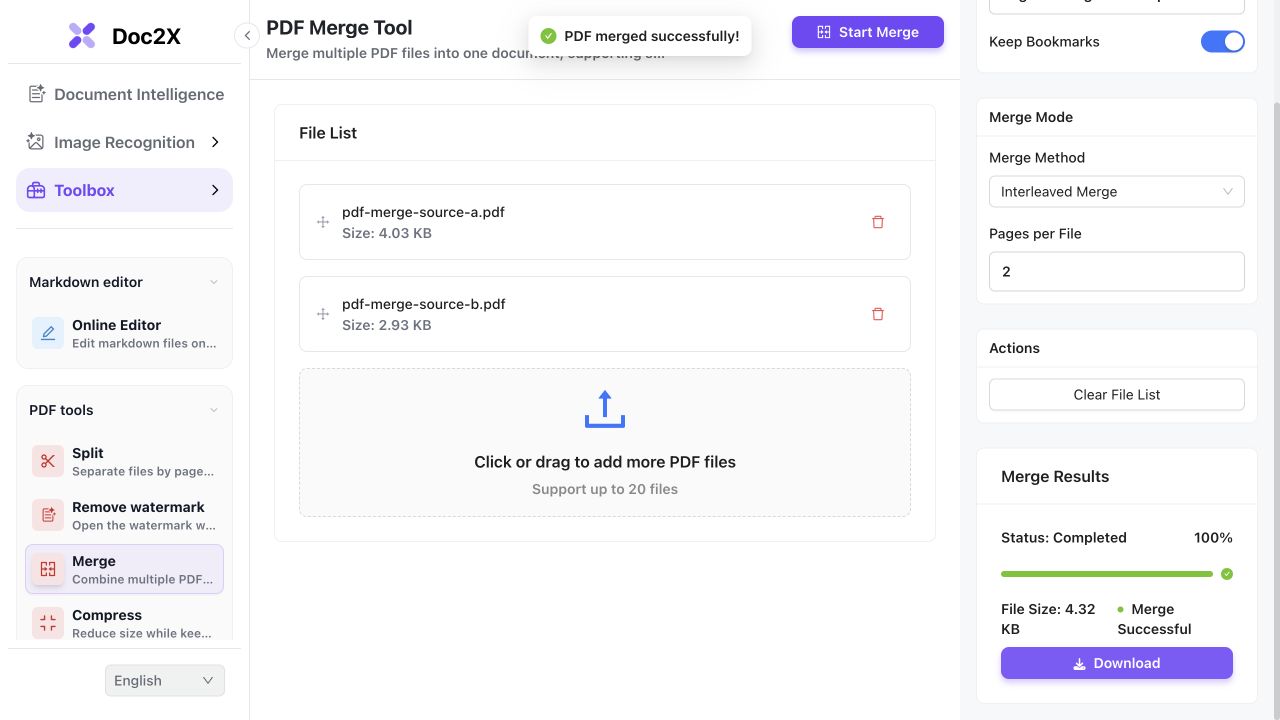
两份五页成品的每页文字、解码后的页面绘制内容、页面框和旋转都与对应原页相同。书签标题和父子层级保持,目标随新位置调整。即使页面交错,书签树仍按来源文件分组;页面上印刷的来源标签也没有重写。
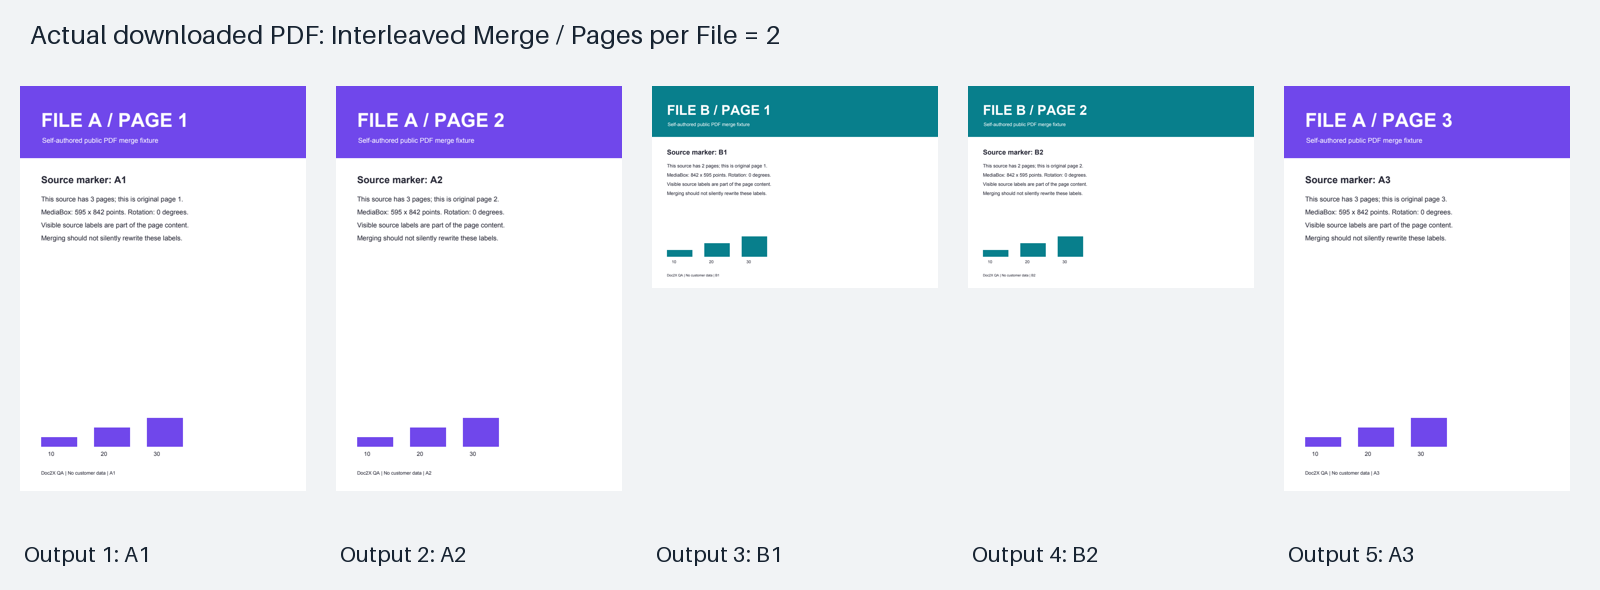
下载原始 PDF、未改写的输出与核对记录。外层 ZIP 和比较图由实际下载件在本地整理生成。这次两文件操作未要求登录或支付,界面标注上限为 20 份,但本例未验证最大数量、大文件、加密、签名或表单。合并不添加 OCR,也不翻译正文。
日文 PDF 合并:英文界面与原始成品
2026-10-13,我们在英文合并工具中选入两份自编日文 PDF:A 有两页面积说明与例题,B 有一页确认问题。使用 Sequential Merge 并开启 Keep Bookmarks,先按 A→B 下载,再用列表排序手柄的 Space → ArrowUp → Space 将 B 移到 A 前,改输出名并重新点 Start Merge,下载第二份结果。
| 原书签 | A→B 的目标页 | B→A 的目标页 |
|---|---|---|
| 第1章:面積の確認 | 1 | 2 |
| 例題:三角形の面積 | 2 | 3 |
| 付録:確認問題 | 3 | 1 |
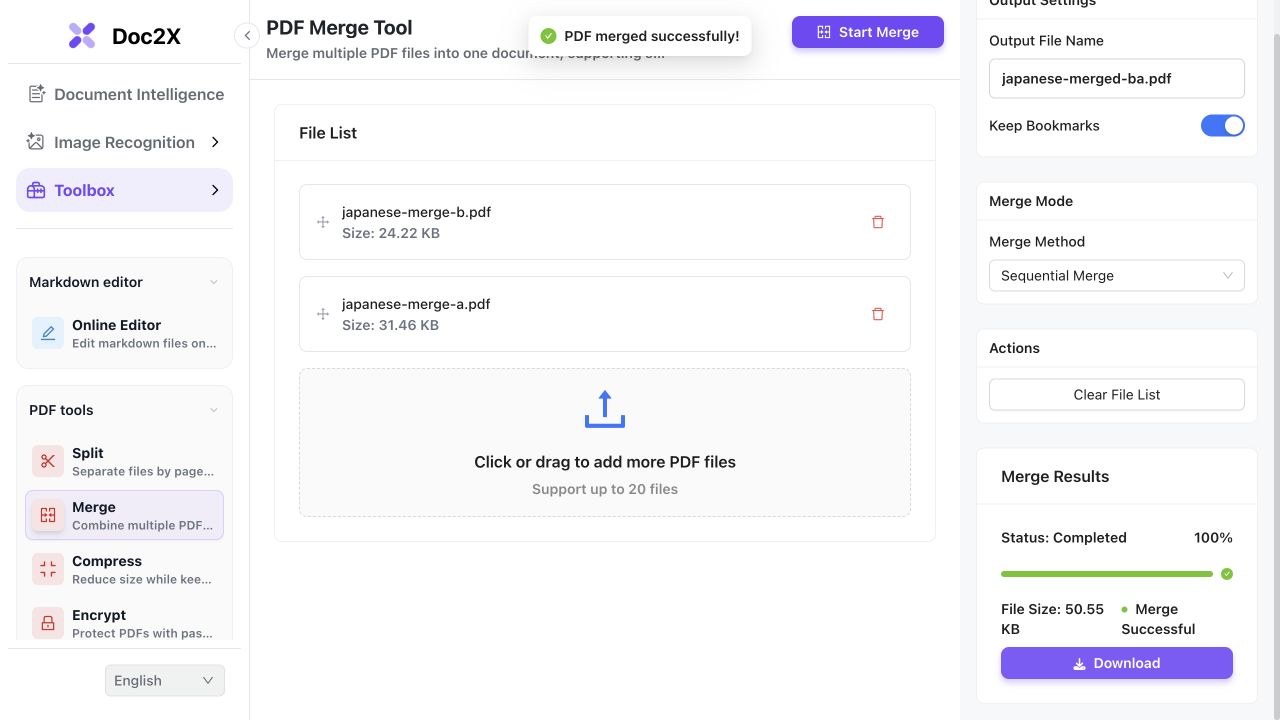
两份实际 PDF 都是三页,对应原页的文字、内容流、嵌入字体、页面尺寸和旋转保持;本地用同一渲染器显示时,对应页像素一致。日文汉字、假名和两条面积公式保留,页内 ORIGINAL PAGE 标记也没有改写。
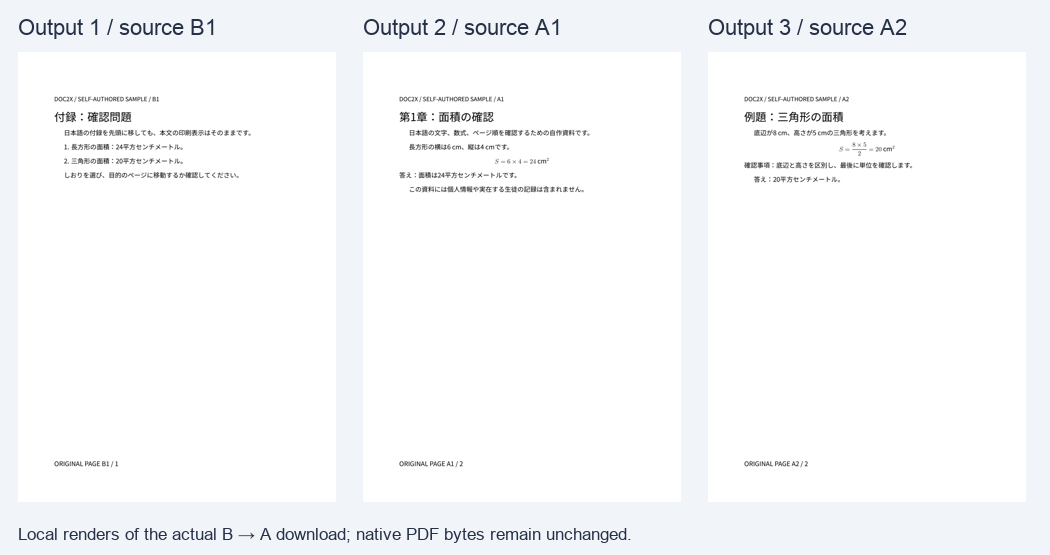
额外在中文书签工具中重新打开 B→A 成品,实际点击三条日文书签,分别到达 1 / 3、2 / 3、3 / 3;未编辑或再次导出。此步骤不代表英文书签界面已验证。普通阅读器也应逐项检查自己的成品。
下载两份原稿、两份未改写的实际成品与核对记录。外层 ZIP 是本地整理的核对包。需要日文操作说明时可看PDF 結合の日本語ガイド,其中明确标注工具使用英文并提供按钮对照。
这组三页样例使用嵌入字体,不能保证任意字体、日文竖排、表单、签名、密码或损坏文件。页面合并不添加 OCR 文字层,也不翻译正文;原文件为图片的文字仍是图片。
两页交错:页序与书签树分别核对
同日用自编的 A 三页与 B 两页复核,选择 交错合并 → 每个文件取页数 2,开启保留书签。实际输出顺序为 A1、A2、B1、B2、A3,五页全部保留,文本、页面尺寸和旋转与相应原页一致。
书签树仍按来源分组:A 的三个目标是新文件第 1、2、5 页,B 的两个目标是第 3、4 页。因此书签树中的页码不是递增列表,也不因此说明目标错了;应核对每个标题是否指向对应来源页。
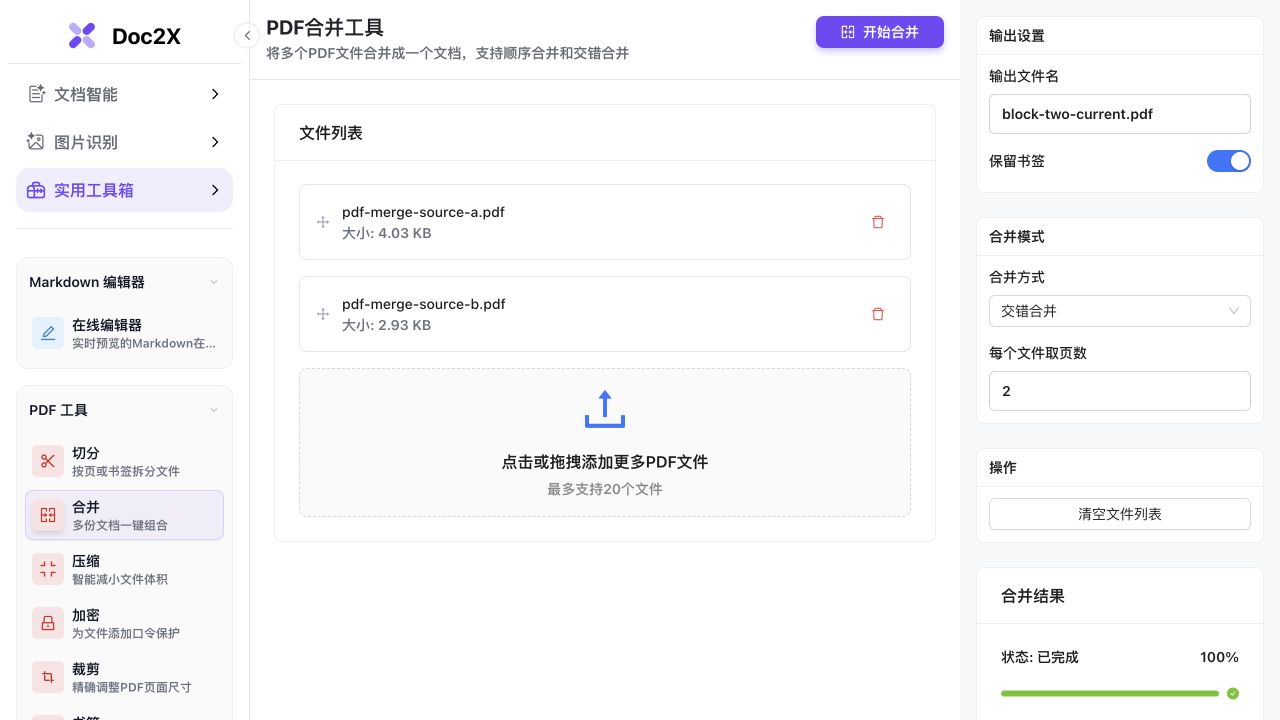
上方核对包同时包含 A/B 原稿及本次两页交错下载。界面截图证明所选条件,实际页序和书签另由下载 PDF 检查;不据此推断任意扫描件都能自动恢复正反顺序。
指定页码拆分,或排好文件顺序后合并。(操作流程示意)。点击图片可在新标签页放大查看。
压缩:比较体积与阅读质量
- 打开 PDF 压缩工具,添加 PDF,每批最多 10 份,文件会自动排队处理。
- 先选 高保真、标准、高压缩 预设。自定义时可调整图片质量、目标 DPI 和重采样阈值;低于阈值的图片不会仅因目标 DPI 较低而缩小像素尺寸。
- 页面范围选 全部页面,或选 自定义范围 并输入如
1-2,5的实际文件页码。自定义范围只输出选中的页面;重复页码保留一次,按原文页序排列。超出某份文件页数时,该文件会显示错误。 - 按需要启用 清除标题/作者信息、快速网页查看 或 优化结构,点击 开始压缩。
- 查看每份的实际大小和“输出页数 / 原文页数”。自定义范围的体积变化包含页面提取,不能全部算作图像压缩效果。下载单个 PDF,或用 下载全部 保存成功结果的 ZIP;重新打开成品检查文字、公式和图表。
压缩档位怎么选
| 档位 | 图片质量参数 | 目标 DPI | 重采样阈值 |
|---|---|---|---|
| 高保真 | 85 | 220 | 300 DPI |
| 标准 | 75 | 150 | 300 DPI |
| 高压缩 | 60 | 120 | 200 DPI |
这些是处理参数,不是清晰度保留百分比。高压缩通常会减少更多图片细节;先从原稿生成候选副本,再放大检查最小字号、上下标、负号和细线。不要连续压缩已经模糊的副本。
文件没有明显变小
压缩不能保证精确达到 500 KB、1 MB 等任意目标大小,当前也没有目标体积输入框。文字型、矢量型或已经压缩过的 PDF,可能没有多少缩小空间。若继续压缩无收益,工具会保留本次选页和文档信息处理后的文件;快速网页查看也可能增加体积。以实际下载大小判断能否提交到目标平台。
若界面提示图片压缩暂不可用,本次仅完成页面提取和文档结构整理,图片质量、DPI 与快速网页查看没有应用。可先下载成功结果,恢复后再从原稿重试。大文件和多页扫描件依赖设备内存,失败时减少批量数量或先拆分。
文字复制与文档信息
压缩不是 OCR:原来没有文字层的扫描 PDF,压缩后仍需识别才能搜索或复制。原来可复制的文件,下载后再次检查文字、数字与阅读顺序;需要重新 OCR 时优先使用清晰原稿。
“清除标题/作者信息”处理原文档的信息字典与文档级 XMP。输出可能仍包含处理程序名称和生成日期;这个选项不能替代对批注、附件或页面内容的检查,也不用于永久删改正文。带书签、表单或签名的文件请保留原件,并在目标阅读器核对这些对象。
先选择压缩质量,再比较体积与页面清晰度。(操作流程示意)。点击图片可在新标签页放大查看。
加密与解密:设置或移除已知密码
一次选择一份 PDF,工具会检查它是否加密。
给 PDF 设置打开密码
- 打开 加密 / 解密,上传未加密 PDF,选择加密页签。
- 输入打开密码,再输入一次确认。妥善保存密码,后续打开和解密需要使用。
- 根据用途设置权限,包括打印、修改、复制、批注、填表、提取和组装等界面列出的选项。
- 点击 开始加密,完成后 下载文件。
- 用 PDF 阅读器打开下载件,确认需要密码并能够正常阅读。
用原密码解密
上传加密 PDF,切到解密页签,输入该文件的原始密码,点击 开始解密。成功后下载,再确认下载件可正常打开。密码错误时修正后重试;本功能不提供无密码破解。当前是单文件流程,没有批量加解密或可自行选择 128/256 位加密算法的操作步骤。
权限限制是否被执行取决于阅读软件,打开密码与编辑/复制权限也不是同一概念;有保密要求的材料应测试实际接收端。
两页样例实测:设置口令、已知密码解密与重新打开
2026-10-12,我们在实际工具中选择一份已公开的自编两页英文 PDF,设置打开口令 WillowDemo!2026,取消 允许打印 和 允许复制内容,其余五项权限保持默认,再点击 开始加密 → 下载文件。这是公开虚构样例专用口令,不是实际文件的密码建议。
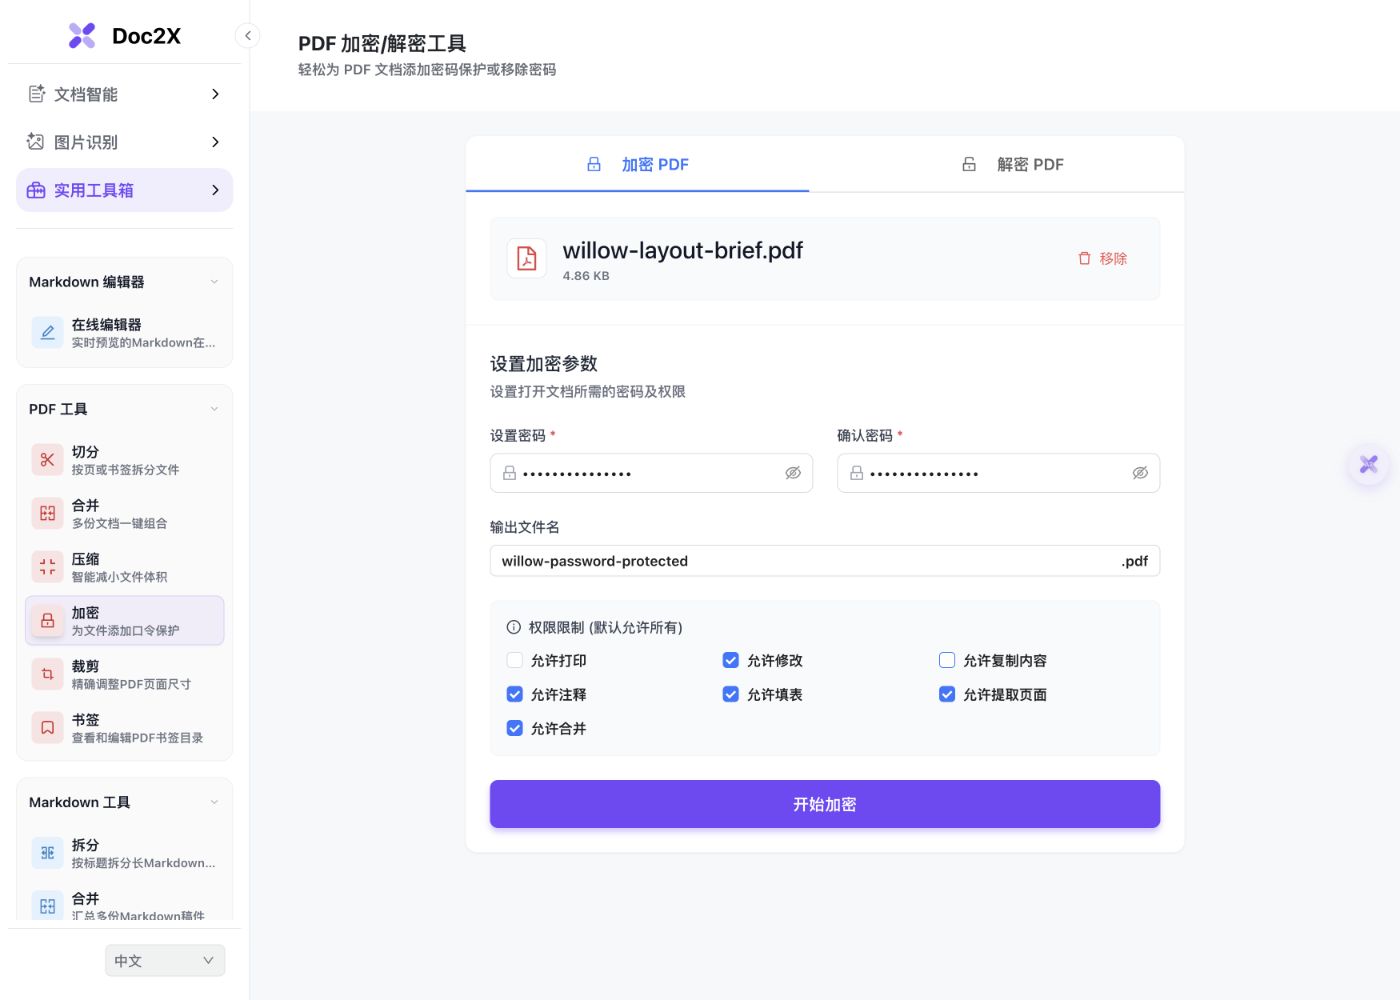
实际文件选择器一次只接收一份 PDF。这里没有批量队列、独立权限密码或算法选择。下载的加密件需要正确密码才能读取;在 Chrome 内置 PDF 阅读器中也出现了密码框,输入正确样例口令后能查看两页内容。
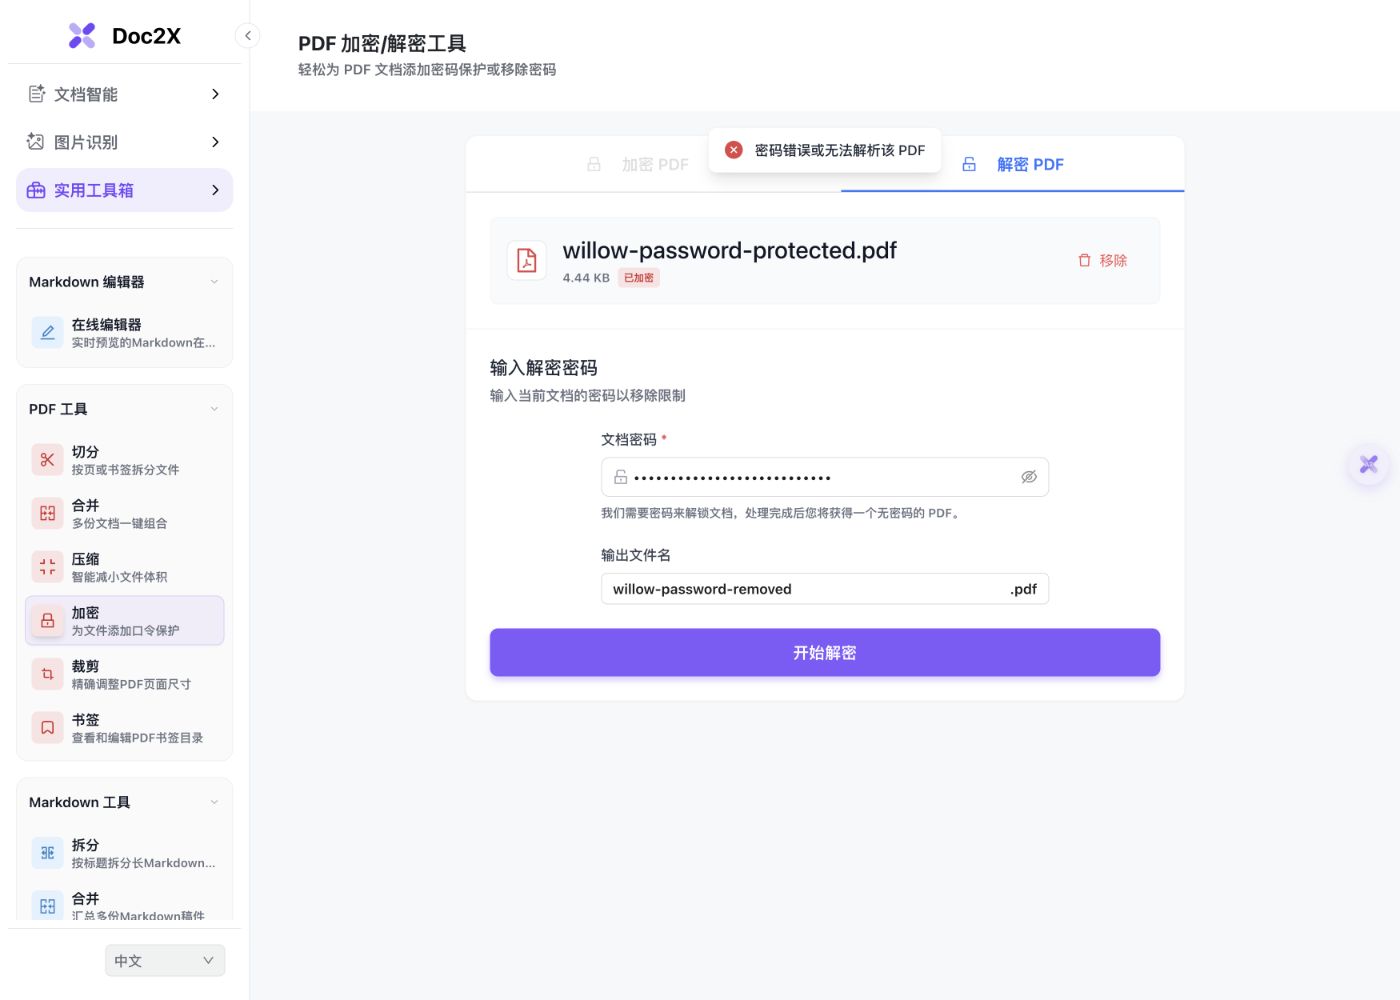
随后选入这份加密件,界面显示 已加密,自动选中 解密 PDF,并禁用加密页签。故意输入错误的演示口令时,实际提示 密码错误或无法解析该 PDF;在同一文件上输入正确原密码后,点击 开始解密 → 下载文件,得到无打开口令的副本。下图记录的是实际错误提示。
| 检查项目 | 这份样例的实际结果 |
|---|---|
| 原稿、加密件、解密件大小 | 4,976 / 4,548 / 4,717 字节,分别保留 |
| 打开行为 | 加密件要求口令;实际解密件在 Chrome 中直接打开 |
| 页数、尺寸与正文 | 都是两页 A4;同参数渲染像素与提取文字一致 |
| 文档属性 | 解密件没有保留原 Title(标题)和 Author(作者)字段 |
| 特殊对象 | 本例没有表单、数字签名或附件,未验证这些对象的保留 |
本例加密件的参数为 V=2、R=3、Length=128,对应 128 位 RC4,不能当作 AES 或高强度保密方案。打印和复制权限位已按选项关闭,但这不证明各个阅读器都按同样方式限制操作。本轮验证了密码提示与打开过程,未对复制或打印限制的实际执行得出可靠结论。关于这些区别,可参考 qpdf 的密码、权限与加密说明。
页面看起来一致,不代表字节、元数据与所有特殊对象均无损。保留原稿,使用清晰文件名区分输出,再核对自己的阅读器和文档内容。三份原生 PDF 与完整说明可从官网 PDF 密码指南下载;忘记或未知密码不属于本例已验证的处理范围。
裁剪:调整页面显示范围
- 打开 裁剪,上传 PDF,在预览中切到需要检查的页面。
- 拖出裁剪框,框住要保留的内容。放大确认页码、页眉和题目没有被误裁。
- 选择 当前页面 或 所有页面。不同页面尺寸、横竖方向或边距不一致时,应先试当前页。
- 点击 开始裁剪,检查处理后预览,再点 下载裁剪结果。
- 打开下载 PDF,检查全部受影响的页面。
裁剪修改的是页面可见区域。框外内容可能仍在 PDF 中,因此不能用来永久删除敏感内容或代替安全涂黑。
设置PDF密码,或调整页面的可见范围。(操作流程示意)。点击图片可在新标签页放大查看。
书签编辑:建立可点击的目录
书签编辑可修改 PDF 阅读器侧栏中的目录,不会把正文标题自动改成新文本。主应用当前打开中文工具界面;英文说明中的按钮可按下列中文名称寻找。
手动编辑并保存
- 打开 书签编辑 并上传 PDF。左侧查看原 PDF,右侧等待已有书签树显示;没有书签也可以从空列表开始。
- 点击 添加,输入标题和对应 PDF 页码。示例添加“讲义”指向第 3 页、“练习”指向第 5 页。
- 编辑已有书签的标题、目标页,调整层级和排序。需要时设置粗体、斜体、颜色以及展开/折叠状态;选中多项可批量设置或删除。
- 点击书签检查跳转。印刷页码可能与 PDF 实际页码不同,必须以预览中的实际位置核对。
- 点击 保存并导出 PDF,等待“书签保存完成”,再 下载文件。用 PDF 阅读器打开下载件并点击新书签。
导入、导出和批量改页码
在 更多操作 中选择 从文本导入。每行一个书签,Tab 缩进表示层级,标题和页码也用 Tab 分隔。按导入弹窗中的样例准备;如果使用书签 JSON,则按工具支持的格式导入。先用两条书签验证,再导入整个目录。
批量偏移页码 支持“页码对应”和“直接偏移”。例如书内印刷第 1 页位于 PDF 第 3 页,先设置这组对应关系,检查首尾书签后应用。已经从 PDF 读取的书签一般无需再次偏移。
导出为文本 可复制书签文本或 导出 JSON 文件。这些文件保存的是书签数据;要把目录写回 PDF,还需要 保存并导出 PDF。
可选:AI 识别目录与翻译书签
- 在更多操作中选 AI 识别目录,配置自己使用的模型服务 API Key、Base URL 和模型名称。
- 填写目录所在的 PDF 页码范围,只选择目录页,点击 开始提取书签。
- 在预览中核对标题、层级和页码。用页码对应/偏移把书中页码对齐到 PDF 页码,检查超出范围的条目。
- 需要翻译时选目标语言,使用 翻译书签,再核对术语与页码。
- 选择 追加到现有书签 或 替换现有书签,点击 导入书签,回到书签树检查,最后保存并导出 PDF。
AI 识别会把选中的目录页图片发送到你配置的模型服务,翻译也使用该服务;这部分需要网络和相应服务额度。没有配置服务时可继续手动编辑或文本导入。识别或翻译结果必须校对,尤其是印刷页码与 PDF 页码的差值。
核对书签目标页,再保存到新的PDF。(操作流程示意)。点击图片可在新标签页放大查看。
下载位置与常见问题
单个 PDF 或 ZIP 位于浏览器下载列表、系统默认下载目录,或保存时选择的位置;客户端以实际下载提示为准。网页预览不等于已经保存,关闭工具前先下载结果。
| 现象 | 处理方法 |
|---|---|
| 无法读取 PDF | 确认文件完整、能被阅读器打开;有密码先用原密码解密,再执行其他处理 |
| 页码范围无效 | 使用从 1 开始的实际 PDF 页码,不填印刷页码;先试 1-2,确认没有超出总页数 |
| 按书签拆分与预期章节范围不同 | 核对源书签目标与选择的层级,再检查单片和ZIP;边界不符合用途时使用明确页码范围 |
| 合并后顺序不对 | 重新排序源文件,先选择顺序合并;交错场景用少量页面验证 |
| 压缩失败或页面无响应 | 先下载已有结果,减少批量文件或拆成较小PDF,重新打开工具再试 |
| 加密或解密失败 | 检查确认密码是否一致、原密码是否正确,再重试;保留未处理的原件 |
| 裁剪后内容不完整 | 回到原文件调整边框,或只裁当前页,再逐页验证 |
| AI目录识别失败 | 检查模型设置和目录页范围;可先手动建立书签,不必等待AI服务 |